bitnet.cppは、Microsoftが公開している1bit LLM(BitNet b1.58)専用の公式推論エンジンだ。「BitNetとは」で検索して来た読者に先に言っておくと、BitNetはモデルの方式、bitnet.cppはそれを動かすソフトで、別のものを指す。この記事はbitnet.cppを実際に動かす側から整理する。LLM全般は LLMとは?仕組み・主要モデル比較・ローカル実行・量子化を一気にまとめる2026年版 を参照。
ENGINE VS MODELBitNetは2つに分かれる
cloneして手に入るのはエンジンだけ。モデルは別に取る
bitnet.cpp
microsoft/BitNet の中身(動かす側)
- 推論エンジン(llama.cpp と同じ立ち位置)
- カーネル I2_S / TL1 / TL2、GPU カーネル
- 単体ではモデルを持たない
BitNet b1.58
重みを {-1, 0, +1} にしたモデル(動かされる側)
- Hugging Face から別途ダウンロード
- 公式は 2B-4T(2.4B)と埋め込み 2 種
- 手元の Llama / Mistral は対象外
30秒でわかるbitnet.cpp
- ・何ができる:重みを{-1, 0, +1}の三値(約1.58ビット)にした1bit LLMを、CPUとGPUで動かす。READMEは100BのBitNet b1.58モデルを単一CPUで毎秒5〜7トークンと公称している。
- ・何を解決する:GPUがない環境でもLLMを動かす。READMEはARMで1.37〜5.07倍、x86で2.37〜6.17倍の速度向上、エネルギー消費は55.4〜82.2%減と公称している。
- ・何を代替する:CPUでの低ビット量子化推論(llama.cppのQ4など)の一部。ただし動かせるのは1.58bitで学習されたモデルだけで、手元のLlamaやMistralは動かせない。
- ・GitHubスター約41,500・フォーク約3,900(2026年11月4日時点)。ライセンスはMIT。
bitnet.cppとBitNet b1.58、1bit LLMの違い
「BitNet」という語は3つの別のものを指す。検索で混乱しやすいので表に分ける。
| 名前 | 正体 | 立ち位置 |
|---|---|---|
| bitnet.cpp | 推論エンジン。リポジトリ microsoft/BitNet の中身 |
llama.cppと同じ。モデルを動かす側 |
| BitNet b1.58 | 重みを{-1, 0, +1}にしたモデルの方式と学習済みモデル | Hugging Faceから取得する動かされる側 |
| BitNet a4.8 / v2 | 活性化を4ビットにする研究(a4.8)と、Hadamard変換で4bit活性化を扱う後継研究(v2) | 論文の話題。bitnet.cppへの統合は2026年11月時点でREADMEに記載なし |
「1bit LLM」「1-bit LLM」で探している場合、実際に動かせる実装の入口がbitnet.cppになる。厳密には初代BitNetが二値{-1, +1}、b1.58が三値で、三値だと情報量はlog2(3)≈1.58ビットになる。「BitNet 2B4T」はモデル名 BitNet-b1.58-2B-4T(2.4Bパラメータ・4兆トークンで学習)の略だ。
READMEはモデル一覧の直後で「既存のHugging Face上の1bit LLMを使って推論能力を示している」と書く。つまりcloneしただけでは動かず、別途モデルを取る。「cloneしたのに動かない」の多くはここが原因になる。
bitnet.cppをCPUで動かす手順
手順に入る前に、READMEにはAzure上の公式オンラインデモへのリンクがあり、ビルドなしでBitNet-b1.58-2B-4Tの応答を確かめられる。自分のCPUで動かす場合の要件は Python 3.10以上・CMake 3.22以上・Clang 18以上で、condaが推奨されている。WindowsはVisual Studio 2022の開発者用コマンドプロンプト(またはPowerShell)から実行する。
HOW IT RUNS推論の通り道
環境に合うカーネルを選び、乗算を加減算で済ませる
-
1.58bit モデル(GGUF)
setup_env.py で I2_S / TL1 / TL2 を指定して変換・ビルド
-
カーネルを選ぶ
I2_S は x86・ARM 共通、TL1 は ARM、TL2 は x86 向け
-
三値の行列積
重みが -1・0・+1 なので足す・引く・飛ばすで計算が終わる
-
トークンを出力
run_inference.py の -cnv で会話モード
git clone --recursive https://github.com/microsoft/BitNet.git
cd BitNet
conda create -n bitnet-cpp python=3.10
conda activate bitnet-cpp
pip install -r requirements.txt
次にモデルを取得してビルドする。
huggingface-cli download microsoft/BitNet-b1.58-2B-4T-gguf --local-dir models/BitNet-b1.58-2B-4T
python setup_env.py -md models/BitNet-b1.58-2B-4T -q i2_s
ビルドが済んだら会話モードで動かす。
python run_inference.py -m models/BitNet-b1.58-2B-4T/ggml-model-i2_s.gguf -p "You are a helpful assistant" -cnv
-n(生成トークン数)・-t(スレッド数)・-temp(温度)はllama.cppと同じ感覚で使える。-p には日本語も渡せるが、日本語の品質はこの記事では検証していない。
つまずきやすい点
- ・
setup_env.pyの--hf-repoで選べるのはBitNet-b1.58-2B-4T、bitnet_b1_58-large/3B、Llama3-8B-1.58、Falcon3/Falcon-Eの1.58bit版など。手元のLlama 3やMistralは渡しても動かない。 - ・Windowsで
clang -vが認識されないときは、開発者シェルで開き直してからビルドする。公式FAQに手順がある。 - ・本記事の手順は公式README準拠で、当サイトでのビルド・実行は未検証。
bitnet.cppの速度は?公式ベンチマークの読み方
数字はすべてREADMEの公称値で、当サイトでの再計測ではない。
OFFICIAL NUMBERS公式の実測レンジ
x86 で最大6.17倍・消費エネルギーは最大82.2%減
6.17倍
x86 CPU の速度向上(最大)
下限は 2.37 倍
5.07倍
ARM CPU の速度向上(最大)
下限は 1.37 倍
82.2%
x86 のエネルギー削減(最大)
ARM は 55.4〜70.0%
| 実行環境 | 速度向上 | エネルギー削減 |
|---|---|---|
| ARM CPU | 1.37〜5.07倍 | 55.4〜70.0% |
| x86 CPU | 2.37〜6.17倍 | 71.9〜82.2% |
READMEは、モデルが大きいほど向上幅が大きいと述べる。比較対象はフルプレシジョンのモデルで、llama.cppのQ4と比べた数字ではない点に注意したい。100Bモデルを単一CPUで毎秒5〜7トークンという数字は、技術レポート(arXiv:2410.16144)に基づく公称だ。
追加の最適化も2つある。2026年1月の並列カーネルとタイリング調整で、元の実装より追加で1.15〜2.1倍(src/README.md)。2026年7月公開の埋め込みモデルは、x86・8スレッドのprefillでF16比、0.6Bが1.42〜2.28倍、270Mが1.32〜1.74倍だ。
3種のカーネルと三値演算の仕組み
bitnet.cppのカーネルは3種類ある。
| カーネル | 対応 | 特徴 |
|---|---|---|
| I2_S | x86・ARM共通 | 汎用。上のクイックスタートで指定したもの |
| TL1 | ARM向け | ルックアップテーブル方式 |
| TL2 | x86向け | ルックアップテーブル方式 |
setup_env.py の -q で選べるのはREADME記載で i2_s と tl1。TL2は対応表上のx86向けカーネルとして載っている。
重みが{-1, 0, +1}に限られるので、行列積の乗算が「足す・引く・飛ばす」で済む。この単純さが、GPUのテンソルコアに頼らないCPU推論の速さにつながる。2025年5月にはGPU推論カーネル(gpu/README.md)も加わり、READMEは次の対応先としてNPUを挙げている。
土台の論文は、BitNet(2023年・arXiv:2310.11453)、BitNet b1.58(2024年・arXiv:2402.17764)、bitnet.cppのシステム論文(2025年2月・arXiv:2502.11880)の3本だ。
bitnet.cppとGPTQ・AWQ・llama.cppの比較
選ぶ基準は「どのモデルを動かしたいか」と「GPUが使えるか」の2点になる。
| 項目 | bitnet.cpp | GPTQ / AWQ | llama.cpp(Q4など) |
|---|---|---|---|
| 量子化 | 1.58ビット(専用に学習) | 4ビット(後から量子化) | Q2〜Q8を選べる |
| 動かせるモデル | 1.58bit版の限られたモデル | 多数 | 多数 |
| 主な実行環境 | CPU、2025年5月からGPUも | 主にGPU | CPU・GPU |
| セットアップ | CMakeとClangでのビルドが必要 | 比較的簡単 | 比較的簡単 |
| 向く場面 | GPUなし、省電力、1.58bitモデルを使う | 既存モデルをGPUで速く | 汎用、量子化レベルを選びたい |
bitnet.cppを選ぶのは、1.58bitモデル(BitNet-b1.58-2B-4Tなど)をCPUで動かす前提がある場合だ。手持ちのLlamaを小さくしたいだけなら、GPTQやllama.cppのほうが現実的になる。速度・メモリの優劣は、モデルとハードを揃えた実測でしか言えず、この表では断定していない。
動かせるモデル
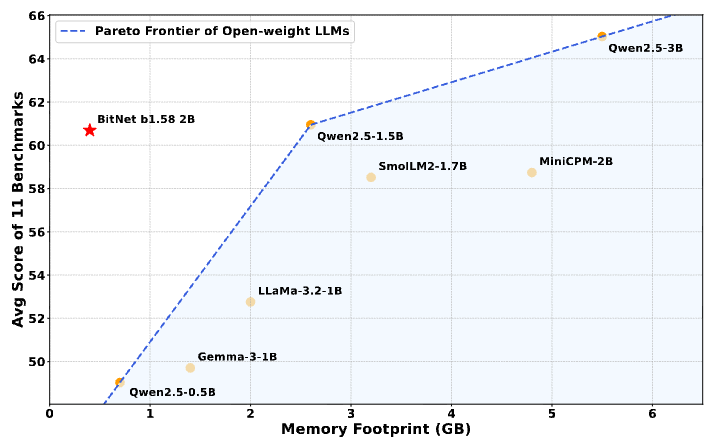
| モデル | パラメータ | 提供元 |
|---|---|---|
| BitNet-b1.58-2B-4T | 2.4B | Microsoft公式。4兆トークンで学習、チャット対応 |
| BitNet-embedding-0.6B/270M | 0.6B/270M | Microsoft公式(2026年7月)。1bit埋め込み、2ビット/重み |
| bitnet_b1_58-large/3B | 0.7B/3.3B | コミュニティ(1bitLLM) |
| Llama3-8B-1.58 | 8.0B | コミュニティ(HF1BitLLM) |
| Falcon3/Falcon-E | 1B〜10B | コミュニティ(TII) |
bitnet.cppが向く用途と向かない用途
向く用途:GPUを置けない環境、ネットワークに出せない社内サーバー、電力に余裕のないエッジ機器、そして1bit量子化の研究。2026年7月には同じI2_S量子化でCPU上のリアルタイム音声認識エンジンVibeASR.cppも公開され、READMEによればx86(AVX2)とARM(NEON)でRTF 1未満を少ないスレッド数で達成した。検索やRAGの前処理に使う埋め込みをCPUで回す用途にも、BitNet-embeddingが加わった。
向かない用途:既存のLlama・Mistralをそのまま小さくしたい場合、モデルの選択肢を重視する場合、ビルド環境を整えたくない場合。READMEのニュース欄は2026年7月23日のVibeASR.cpp公開が最新で、2026年11月4日時点でそれ以降の追加はない。対応モデルの拡大とNPU対応が今後の焦点だ。
GPUの高速化を別の手法で狙うならDFlash × vLLM の使い方|投機的デコーディングを最大6倍にするブロック拡散ドラフト、複数台のCPUをつなぐならDistributed Llama:家庭用デバイスを繋ぐだけでLLMローカル実行を高速化する分散フレームワークが使い分けの対象になる。GUIで一式を動かすならClaraVerse:LLMローカル実行対応のプライバシー重視プライベートAIプラットフォーム完全ガイドもある。
この記事の結論
- ・bitnet.cppは1.58bitモデル専用のエンジン。モデルは別に取る。
- ・速度・省エネの数字はREADMEの公称。環境で必ず自分で測る。
- ・手持ちのモデルを使うなら、GPTQ・AWQ・llama.cppが先。
参照ソース
- microsoft/BitNet - GitHub
- BitNet: Scaling 1-bit Transformers for Large Language Models - arXiv
- The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits - arXiv
- Bitnet.cpp: Efficient Edge Inference for Ternary LLMs - arXiv
- 1-bit AI Infra: Part 1.1, Fast and Lossless BitNet b1.58 Inference on CPUs - arXiv
- BitNet v2: Native 4-bit Activations with Hadamard Transformation for 1-bit LLMs - arXiv
- BitNet b1.58 2B4T - Hugging Face